AIの__usage_ai-trainingは、
11月1日7時41分時点の、
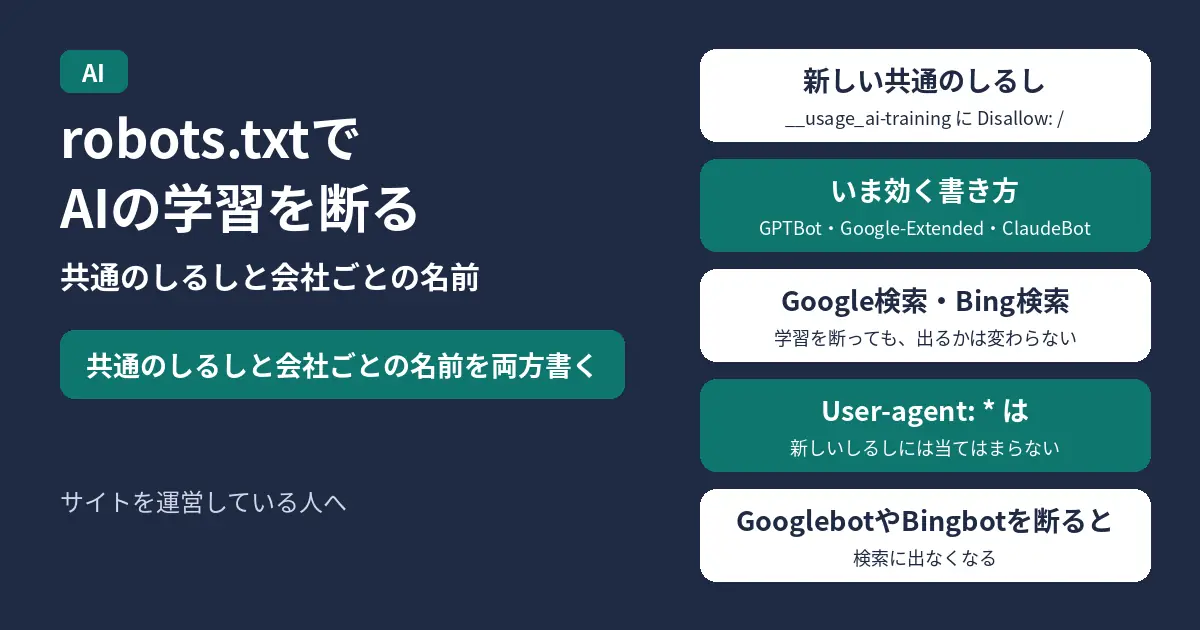
結論:AIの学習を断るrobots.txtの要点
| 項目 | 内容 |
|---|---|
| 新しい |
User-agent: __usage_ai-trainingのDisallow: /と書く |
| 効き始める時期 | Microsoftは |
| いま効く |
GPTBotDisallow: /にする |
| 検索への影響 | Google-Extendedや |
| 気を |
User-agent: *のDisallowに |
新しい共通のしるし__usage_ai-trainingの書き方
サイト全体をAIの学習に使わせない
User-agent: __usage_ai-training
Disallow: /サイトの__usage_ai-trainingは、
一部のページだけ学習に使ってよいことにする
User-agent: __usage_ai-training
Disallow: /
Allow: /press-kit/この/press-kit/の
新しいしるしについて知っておくこと
- IETFの
文書は、 2026年10月30日に 出た インターネットドラフト (下書きの 段階の 文書)で、 IETFが 認めた 標準ではありません。 中身が 変わる こともあります。 User-agent: *のグループは、 この しるしに 当ては まりません。 __usage_ai-trainingのグループが ない robots.txtは、 「学習に ついて 何も 意思を 示していない」と 扱われます。 - この
しるしは、 ロボットの 巡回を 止める ものではありません。 巡回 その ものを 止めたい ときは、 ロボットの 名前で 書きます。 - 会社ごとの
名前で 書いた ルールは、 共通の しるしより 優先される ことがあります。
いま効く、会社ごとの書き方
OpenAI・Google・Anthropicの学習を断る
User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: ClaudeBot
Disallow: /| 名前 | 会社 | 断った |
|---|---|---|
| GPTBot | OpenAI | サイトの |
| Google-Extended | Geminiの |
|
| ClaudeBot | Anthropic | これから |
Anthropicは、
いまとこれからの両方に対応する
User-agent: __usage_ai-training
Disallow: /

User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: ClaudeBot
Disallow: /
OpenAIも
検索やAIの回答に出るかどうかへの影響
Google-Extendedは、
Google-Extendedを
Geminiアプリの回答には出て、ほかの学習は断る
User-agent: __usage_ai-training
Disallow: /

User-agent: Google-Extended
Allow: /
Google-Extendedを
OpenAI
ChatGPTの
Microsoft(Bing)
Microsoftは、
1ページだけBingの学習を断る
<meta name="Bingbot" content="ai-training:disallow">ページのheadの
Anthropic
Anthropicは、
出典
- IETF|
Machine-Readable Training Preference Signal - Google検索セントラル ブログ|
AIの 学習の 新しい コントロール (2026年10月30日) - Google|
Googleの 一般的な クローラー (Google-Extended) - Microsoft
Bing|Your content, your choice (2026年10月30日) - OpenAI|
Helping websites express AI training preferences - OpenAI|
Overview of OpenAI Crawlers - Anthropic|
Does Anthropic crawl data from the web, and how can site owners block the crawler?

コメント