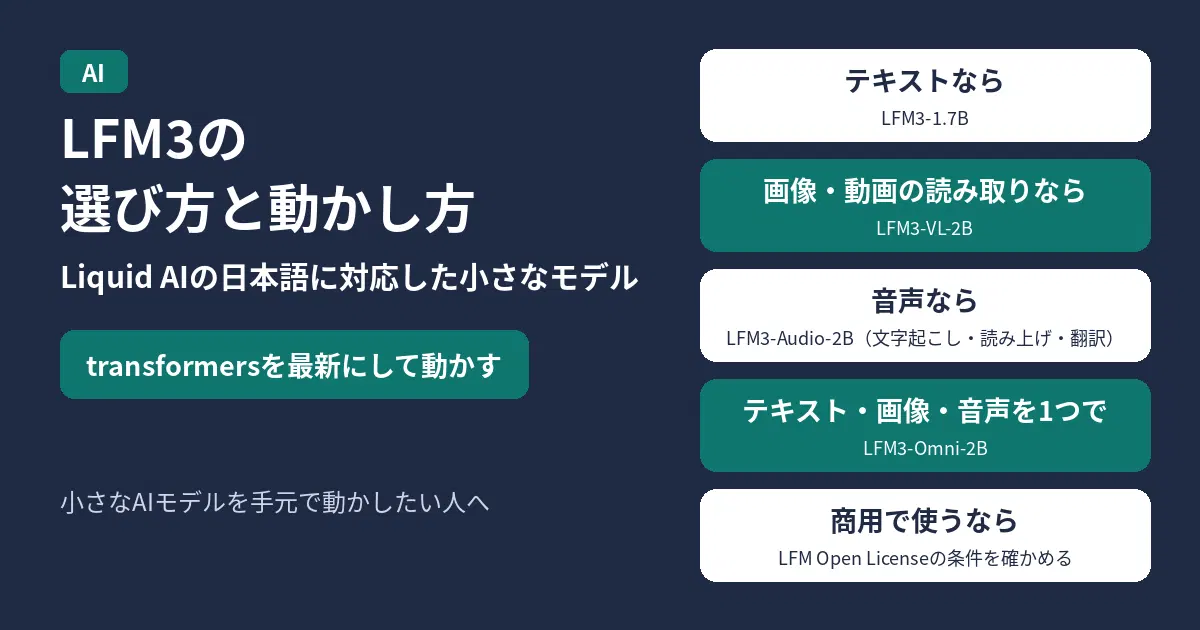
LFM3は、
6種類とも、
- 2026年10月28日8時29分
(日本時間) 時点の、 Liquid AIの ブログと Hugging Faceの モデルカードの 内容です。
結論:用途ごとに選ぶモデル
| モデル | 向いている用途 |
|---|---|
| LFM3-1.7B | テキスト。 |
| LFM3-VL-2B | 画像と |
| LFM3-Audio-2B | 音声の |
| LFM3-Omni-2B | テキスト、 |
| d1-2B | 判定用 |
| d1-Omni-2B | 判定用 |
d1-2Bと
日本語に対応しているか
モデルカードの
- LFM3-1.7B、
LFM3-VL-2B:テキストは 日本語を 含む16言語 - LFM3-Audio-2B:音声は
日本語を 含む18言語 - LFM3-Omni-2B:テキストの
16言語と、 音声の 18言語の 両方に 日本語が 入っている - d1-2B:テキストは
日本語を 含む16言語 - d1-Omni-2B:テキストの
16言語に 日本語が 入っている。 音声は、 そのうちヒンディー語、 タイ語、 ベトナム語、 インドネシア語を 除く 12言語
テキストの
LFM3-1.7Bの性能と大きさ
- パラメーター数:
17.3億(1.73B) - 扱える
長さ (コンテキスト長): 256Kトークン (入力と 出力の合計) - メモリ:
4ビットに 量子化すると 約1GBで、 スマホや ノートパソコンに 収まる - パラメーター数は
前の モデルLFM2.5-2.6Bより 35%少ないのに、 LFM2.5-2.6Bを 上回る - エージェントの
ベンチマーク 「WebArena-Verified」: 38.42 (LFM2.5-2.6Bは3.02)
Liquid
LFM3-VL-2Bの性能
LFM3-VL-2Bは、
LFM3-1.7Bを動かす
まず、
pip install -U transformerstransformersで実行する
from transformers import pipeline

generator = pipeline(
    "text-generation",
    model="LiquidAI/LFM3-1.7B",
    trust_remote_code=True,
)

messages = [{"role": "user", "content": "日本の首都はどこですか?"}]
output = generator(
    messages,
    do_sample=True,
    temperature=0.1,
    top_k=50,
    repetition_penalty=1.1,
    max_new_tokens=2048,
)
print(output[0]["generated_text"][-1]["content"])
Liquid temperature=0.1を、temperature=1.0・top_p=0.95・top_k=20を
そのほかの動かし方
- GPUで
動かす: vLLM、 SGLang、transformers - パソコンや
スマホで 動かす: GGUFの モデルを、 llama.cpp、 Ollama、 LM Studioで 使う。 MLX用の 4ビットの モデルもある
llama.cppを
ほかのモデルを動かすときに入れるもの
モデルカードに
LFM3-VL-2B
pip install "transformers>=5.21.0" torch torchvision pillowLFM3-Audio-2B
pip install "transformers>=5.20.2" torch accelerate librosa soundfileLFM3-Omni-2B
pip install "transformers>=5.20.2" torch torchvision torchcodec accelerate pillow librosa soundfiled1-2B・d1-Omni-2B
pip install "transformers>=5.19" torch torchvision pillowライセンスと商用利用
LFM3の
条件を
よくある質問
日本語で会話できますか?
LFM3-1.7Bの
スマホやノートパソコンで動きますか?
Liquid
公式の発表
2026年10月28日8時29分

コメント