KRAFTON AIの
モデルカードには、
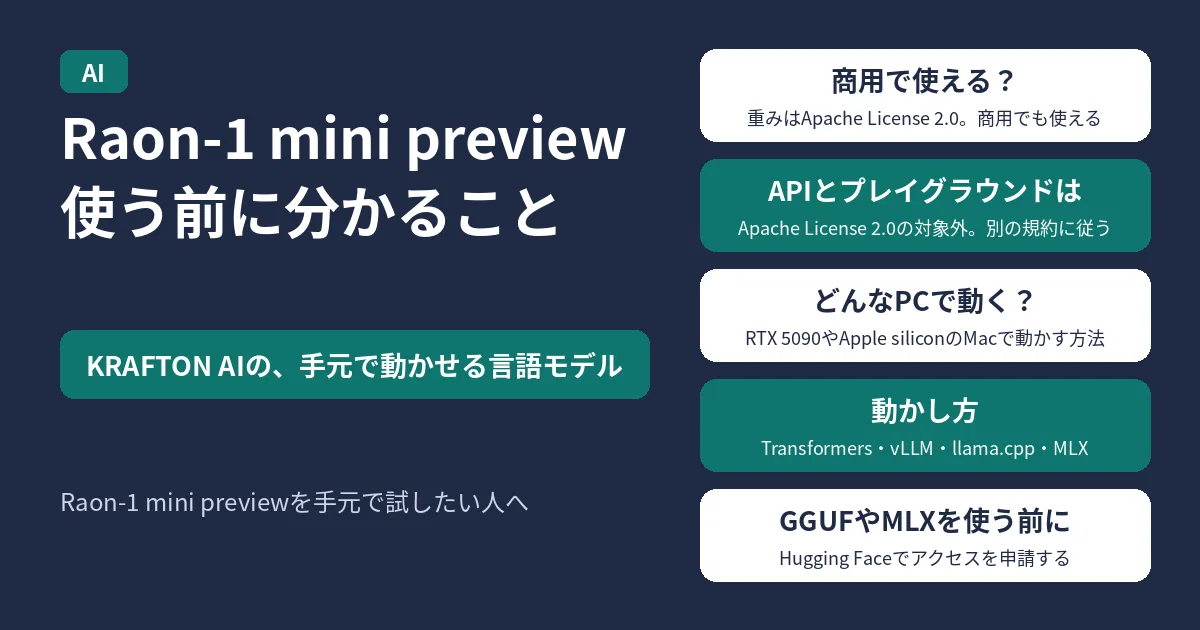
結論:商用で使えて、RTX 5090の1枚でも動く
- 重みや
設定ファイルなどは Apache License 2.0です。 商用の 目的も 含めて、 ダウンロード、 利用、 改変、 再配布が できます。 - KRAFTONの
APIと プレイグラウンドは Apache License 2.0の 対象外で、 別の 規約に 従います。 - NVFP4の
モデルなら、 VRAMが 32GBの RTX 5090の 1枚で 動くと モデルカードに あります。 - 動かし方は、
Transformers、 vLLM、 llama.cpp、 MLXの 4つです。 vLLMと llama.cppは、 KRAFTONが 用意した ものから インストールします。 - GGUF、
MLX、 NVFP4の Hugging Faceの リポジトリは 申請制で、 承認は 自動です。 本体の リポジトリは、 2026年10月25日の 時点で 申請なしで 使えます。 - previewの
バージョンなので、 正式な バージョンまでに 仕様や 結果が 変わる ことがあります。 - 2026年10月25日8時49分
(日本時間) 時点の モデルカードの 内容です。
Raon-1 mini previewとは
KRAFTON AIが
本体の
| 項目 | 内容 |
|---|---|
| パラメーターの総数 | 288億(28.8B) |
| 1トークンで |
43億(4.3B) |
| 層の数 | 25層 |
| エキスパート | 128個の |
| コンテキストの長さ | 262,144トークン |
| ライセンス | Apache License 2.0 |
KVキャッシュを
考える
商用で使えるか
使えます。
ただし、
ホスティングしている
手元で
どれくらいのPCで動くか
モデルカードが
| 環境 | 使う |
|---|---|
| RTX 5090(32GB) | NVFP4の |
| VRAMが |
MXFP8の |
| DGX Spark | NVFP4の |
| Apple siliconのMac | MLXの |
| llama.cpp | KRAFTONの |
vLLMでの
llama.cpp向けの
| 量子化 | ファイルの |
|---|---|
| IQ4_XS | 16.1GB |
| Q4_K_M | 19.7GB |
| Q5_K_M | 22.2GB |
| Q6_K | 25.8GB |
| Q8_0 | 30.7GB |
動かすのに
GGUFやMLXを使う前に、アクセスを申請する
GGUF、
申請では、
申請したら、
pip install -U huggingface_hub
hf auth loginllama.cppで動かす
llama.cppの
git clone -b raon-1-mini-preview \
    https://github.com/krafton-ai/llama.cpp
cd llama.cpp

# Apple siliconでは -DGGML_CUDA=ON を外す
cmake -B build -DGGML_CUDA=ON
cmake --build build --config Release -j
次の
./build/bin/llama-cli \
    -hf KRAFTON/Raon-1-mini-preview-gguf:Q4_K_M \
    --ctx-size 262144 \
    --n-predict 32768 \
    --temp 1.0 \
    --top-p 0.95 \
    --top-k 20 \
    --min-p 0.0 \
    --repeat-penalty 1.0 \
    --frequency-penalty 0.0 \
    --presence-penalty 1.5 \
    --reasoning on \
    --chat-template-kwargs '{
      "enable_thinking": true,
      "truncate_history_thinking": false
}'llama-serverを
モデルカードがtemperatureがtop_pがtop_kがpresence_penaltyは、
Macで動かす(MLX)
Apple siliconの
python3 -m venv .venv
source .venv/bin/activate

python -m pip install \
    "mlx==0.32.4" \
    "mlx-lm==0.32.2" \
"transformers==5.20.1"モデルカードには、mlx_lm serverで
試すだけならプレイグラウンド
手元で

コメント