「AIエージェントを、クラウドではなく自分のPCで動かしたい。でも24GBのGPUやMacで本当に動くのか、仕事で使ってもいいのかがわからない」という方へ。Metaのオープンモデル「Muse Glimmer 30B」は、24GBのGPUならK-Quant-17GB版で画像の読み取りまで動き、MacではOllamaのMLX版が使えます。ライセンスはApache 2.0で、商用での利用も想定されています。
Muse Glimmer 30Bとは
Muse Glimmerは、MetaのMeta Superintelligence Labsが作った、手元のパソコンでエージェントを動かすためのAIモデルです。Hugging Faceのモデルカードによると、上位モデルのMuse Sparkから蒸留(大きなモデルの知識を小さなモデルに移すこと)して作られていて、クラウドやネット接続なしで動くように作られています。
モデルの公開は2026年8月です。Ollamaの公式ブログも2026年8月10日に対応を発表しています。そのうえで、Metaは2026年10月19日に技術論文を公開しました。10月に出たのは論文で、モデル自体は8月から使えます。
| 項目 | 内容 |
|---|---|
| パラメータ数 | 約29.6B(画像用のエンコーダーを含む) |
| しくみ | Dense(すべてのパラメータを毎回使う)のTransformerと、約1.8Bの画像用エンコーダー |
| 入力/出力 | 入力はテキストと画像、出力はテキスト。音声は非対応 |
| コンテキスト長 | 131,072トークン以上 |
| 言語 | 100以上の言語のデータで学習 |
| 知識の区切り | 2026年1月4日 |
| ライセンス | Apache 2.0 |
得意なこととしてモデルカードに挙がっているのは、何ステップも続く作業の計画、ツールの呼び出し、失敗したときのやり直し、スクリーンショットや図・書類の読み取りです。OpenClawやHermes Agentといったエージェントの仕組みで使えるとしています。
ベンチマークでは、同じくらいの大きさのGemma4-31BやQwen3.6-27Bと比べて、MCP AtlasやDeepSearch QAなどのエージェント系で高い点が出ていると、Metaは説明しています。一方で、OSWorld-VerifiedやTerminalBench 2.1などではQwen3.6-27Bのほうが上で、すべての項目で勝っているわけではありません。どれもMetaが測った数字です。
必要なメモリ:24GBのGPUで動く?
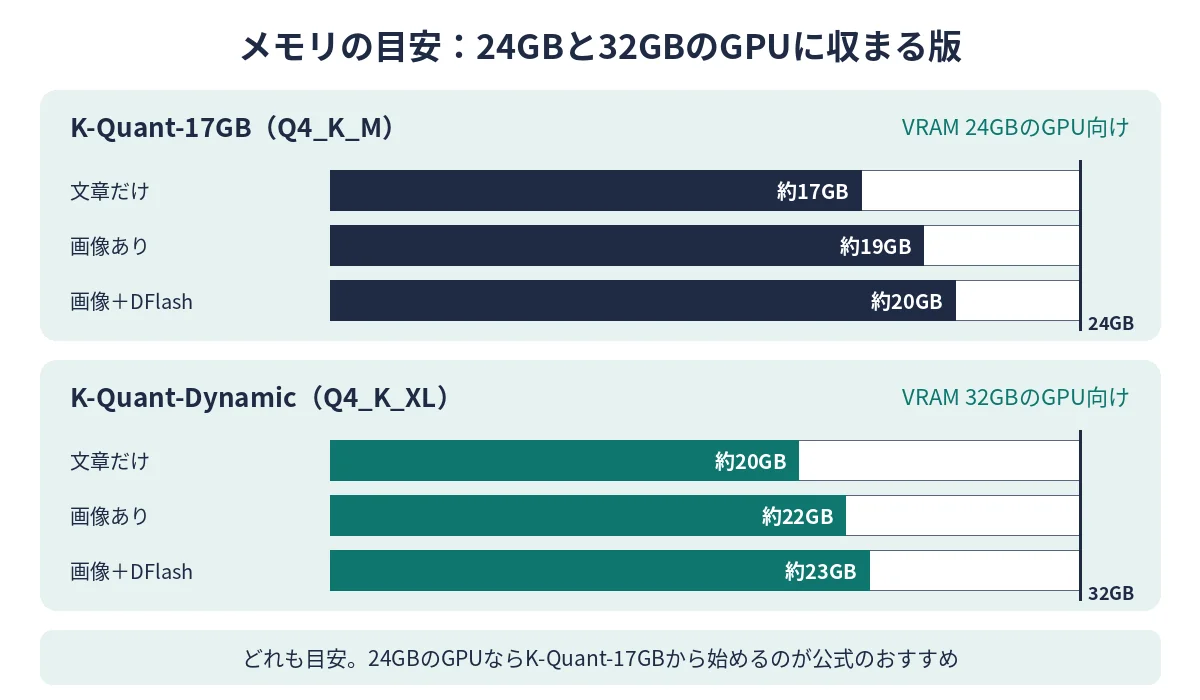
モデルの重みを約4ビットに圧縮(量子化)した版が配布されていて、文章を扱う本体は20GB未満に収まります。モデルカードでは、24GBまたは32GBのGPUで、画像用のエンコーダーや高速化用の小さなモデルまで一緒に動かせるとしています。
| 版 | ファイルの大きさ | メモリの目安(文章だけ/画像あり/画像+高速化) | 想定するGPU | 精度の低下 |
|---|---|---|---|---|
| K-Quant-17GB(Q4_K_M) | 16.8GB | 約17GB/約19GB/約20GB | VRAM 24GB | 1.0% |
| K-Quant-Dynamic(Q4_K_XL) | 19.7GB | 約20GB/約22GB/約23GB | VRAM 32GB | 0.2% |
| フル精度(bf16) | 約60GB | — | VRAM 64GB | — |
画像を読ませるには、別ファイルの画像用エンコーダー(1.4GB)が必要です。高速化用の小さなモデル「DFlash」(1.6GB)は、なくても動きます。精度の低下は、15のベンチマークの平均でフル精度と比べたMetaの数字です。
Metaの開発者向けドキュメントでは、K-Quant-17GBに画像用エンコーダーを加え、131,072トークンのコンテキストをすべて使ったときに、VRAMを19.0GiB使ったと書かれています。DFlashを足すと、さらに約1.5GiB増えます。24GBのGPUなら、K-Quant-17GBから始めるのが公式のおすすめです。
Macでは動く?
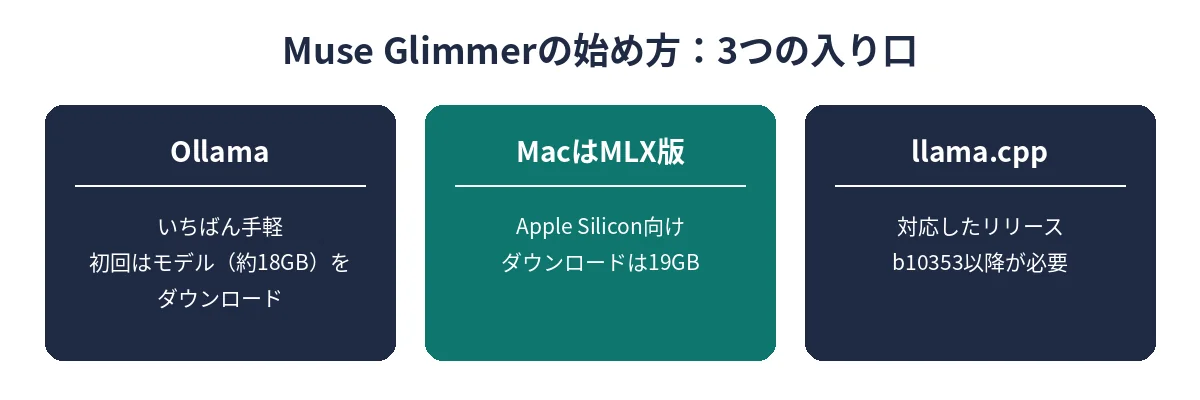
Ollamaには、Apple Silicon向けのMLX版(ダウンロードは19GB)が用意されています。モデルカードでは、MacBookのM4 MaxとM5 Maxで速度を測った結果ものっています。
| 環境 | DFlashなし | DFlashあり |
|---|---|---|
| NVIDIA RTX 5090 | 毎秒74.9トークン | 毎秒233.4トークン(3.1倍) |
| Apple M4 Max | 毎秒23.7トークン | 毎秒37.8トークン(1.5倍) |
| Apple M5 Max | 毎秒26.6トークン | 毎秒50.2トークン(1.8倍) |
ただし、Macのメモリ(ユニファイドメモリ)が何GBあれば動くかは書かれておらず、公式では未確認です。ダウンロードの大きさ(19GB)に加えて、macOSやほかのアプリが使う分も必要になるので、メモリに余裕のあるMacで試すのが安心です。
Ollamaで動かす
いちばん手軽なのはOllamaです。Ollamaをインストールしたら、ターミナルでこのコマンドを実行します。初回はモデル(約18GB)のダウンロードが始まります。
ollama run muse-glimmerApple SiliconのMacでは、MLX版を指定します。
ollama run muse-glimmer:30b-mlxClaude Codeなどのコーディングエージェントから使うこともできます。
ollama launch claude --model muse-glimmerOllamaの主なタグ(タグの一覧)は、こうなっています。
| タグ | 大きさ | 向いている環境 |
|---|---|---|
| muse-glimmer(latest、30b) | 18GB | まずはこれ |
| 30b-mlx | 19GB | Apple SiliconのMac |
| 30b-mxfp8 | 33GB | メモリに余裕があるApple SiliconのMac |
| 30b-mlx-bf16 | 60GB | フル精度で動かしたいMac |
llama.cppで動かす
llama.cppを使う場合は、Muse Glimmerに対応したリリースb10353以降が必要です。それより古いと、モデルを読み込めません。バージョンはこのコマンドで確かめられます。
./llama-cli --versionモデルはHugging Faceからダウンロードします。24GBのGPU向けのK-Quant-17GBと、画像用エンコーダーを取ってくる例です。
pip install -U huggingface_hub

hf download meta-models/Muse-Glimmer-30B-GGUF \
    --local-dir Muse-Glimmer-30B-GGUF \
    --include "Muse-Glimmer-30B-KQuant-17GB-Q4_K_M.gguf" \
--include "mmproj-Muse-Glimmer-30B-Q4_K_M.gguf"文章だけで試すなら、llama-cliで起動します。--jinjaは必ず付けます。
./build/bin/llama-cli \
    -m Muse-Glimmer-30B-GGUF/Muse-Glimmer-30B-KQuant-17GB-Q4_K_M.gguf \
    -ngl 99 -c 32768 \
    --jinja \
    --temp 1.0 --top-p 0.95 --top-k 64
Muse Glimmerは答える前に必ず考える(推論する)モデルで、推論をオフにはできません。考える量は low・medium・high・xhigh の4段階で選べて、何も指定しないと high です。コーディングやエージェントの作業には high か xhigh が勧められています。
商用で使える?
Muse GlimmerはApache 2.0ライセンスで、フル精度の重み、4ビット版、DFlash、画像用エンコーダーのすべてが同じライセンスで配布されています。モデルカードでも「商用と研究での利用を想定している」と書かれています。
そのうえで、モデルカードには使い方の注意も書かれています。
- 法律や規制(輸出入の規制を含む)に反する使い方はできない
- 18歳未満の人がダウンロードしたり使ったりすることは想定されていない
- 取り消せない操作をエージェントにさせるときは、人が確認する仕組みなどの安全策を加えることが勧められている
実際に製品に組み込むときは、Apache 2.0の条件(著作権表示やライセンス文の同梱など)を確かめてください。
ほかのモデルとのちがい
当サイトで紹介したMetaのMuseシリーズや、手元で動かすモデルとの役割のちがいです。
| モデル | 使い方 | 動かすのに必要な環境の目安 |
|---|---|---|
| Muse Glimmer 30B | 自分のPCで動かす。Apache 2.0 | VRAM 24GBのGPUから |
| Muse Spark Open | 重みを配布する大型モデル(816B)。Muse Model License | NVFP4版で700GB以上のVRAM |
| Muse Wonder | Muse Codeでも使える | Meta Model APIで提供されている |
| Nemotron 3.5 Bolt | NVIDIAの手元向けモデル(74B、2ビット量子化) | 24GBのメモリに収まるように作られている |
「24GBのGPUで動き、Apache 2.0で仕事にも使いやすいエージェント向けのモデル」を探しているなら、Muse Glimmerは候補になります。もっと大きなモデルの性能が必要なら、Muse Spark OpenやMuse Wonderの記事も比べてみてください。
まとめ
- Muse Glimmer 30Bは、Metaが2026年8月に公開した、手元のPCでエージェントを動かすためのモデル。10月19日に論文が出た
- 約4ビット版なら、24GBのGPUで画像の読み取りまで動かせる(公式の測定で約19GiB)
- MacはOllamaのMLX版(19GB)が使えるが、必要なメモリの量は公式では未確認
- Ollamaなら
ollama run muse-glimmerで始められる。llama.cppはb10353以降が必要 - Apache 2.0で、商用利用も想定されている
まずはOllamaで動かし、いつも任せたい作業を1つ試して、速さと答えの質が自分の用途に合うかを確かめてみてください。

コメント