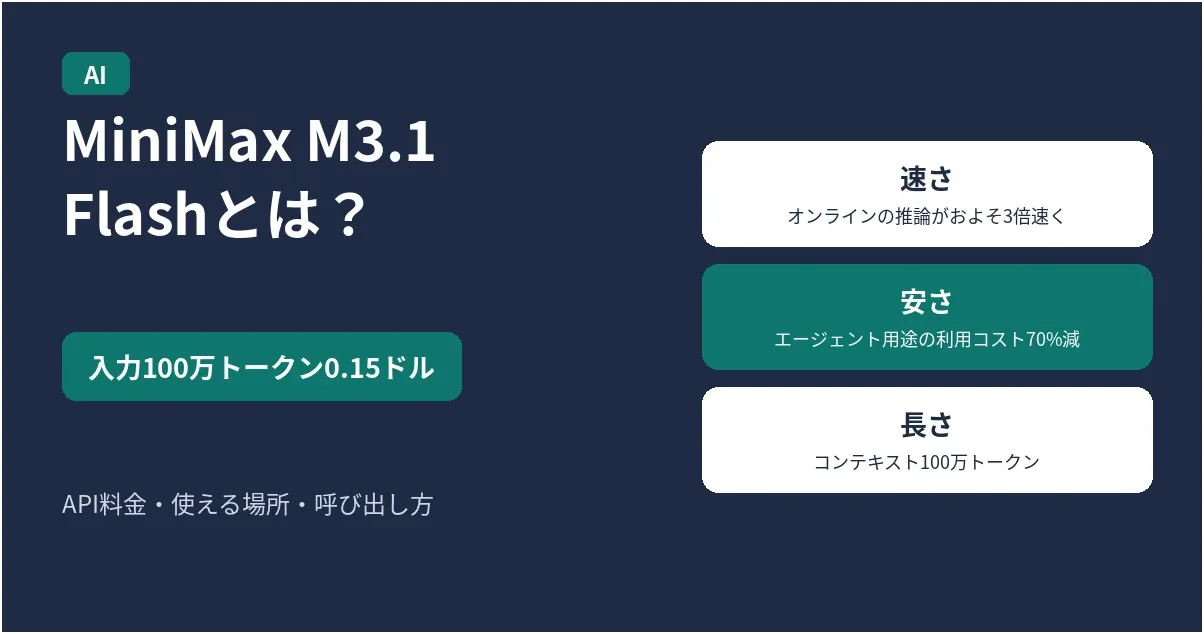
AIのAPIを使ってエージェントやコーディングの仕組みを作っていて、「もっと安くて速いモデルはないか」と探している開発者の方へ。2026年10月19日にMiniMaxが出したMiniMax M3.1 Flashは、API料金が100万トークンあたり入力0.15ドル・出力0.60ドルの、エージェントやコーディング向けのモデルです。
MiniMax M3.1 Flashとは
MiniMax M3.1 Flashは、中国のAI企業MiniMaxが2026年10月19日の公式ブログで正式に出した、エージェント向けの言語モデルです。MiniMaxは、エージェントの作業、コーディング、コンピューター操作(Computer Use)、サイバーセキュリティの4つの分野で大きく性能が上がったとしています。
- 速さ:オンラインでの推論がおよそ3倍速くなり、出力は普段使いで毎秒200トークン以上、中央値でも毎秒170トークン以上
- 安さ:エージェント用途での利用コストが、前のモデルより70%下がった
- 扱える長さ:APIドキュメントでは、コンテキストは100万トークン。テキストのほか、画像と動画も入力できる
正式な発表の前に、匿名で公開されていた「Space Bunny」というモデルが、M3.1 Flashの初期版だったとも書かれています。
ベンチマーク(MiniMaxの発表)
| 分野 | ベンチマーク | スコア |
|---|---|---|
| 複雑な業務の自動化 | BankerToolBench | 76.2 |
| コーディング | DeepSWE v1.1 | 73.7% |
| コンピューター操作 | OSWorld V2 | 61.7 |
| 専門的な実務 | Agents’ Last Exam(ALE) | 29.6 |
| サイバーセキュリティ | CyberGym | 82% |
どれもMiniMaxによる数字です。OSWorld V2とALEでは、中国のモデルの中で1位だとしています。ほかの会社のモデルと同じ条件で比べた結果かどうかは、ブログの文からはわからず、公式では未確認です。
API料金
料金は、入力の長さに関係なく一律です。MiniMaxの料金ページでも同じ金額が載っています。
| 項目 | 100万トークンあたり |
|---|---|
| 入力 | 0.15ドル |
| 出力 | 0.60ドル |
| キャッシュされた入力 | 0.015ドル |
「70%安い」の意味
ブログの「70%安い」は、エージェント用途での全体の利用コストを前のモデルと比べた数字です。トークン1つあたりの値段が70%下がったという意味ではありません。
同じ料金ページでは、ひとつ前の世代のMiniMax-M3(入力51.2万トークンまで)が入力0.30ドル・出力1.20ドル・キャッシュ入力0.06ドルとなっています。ただし、ブログの「前のモデル」がM3のことなのかは書かれておらず、公式では未確認です。
DeepSeekのFlashモデルと比べると
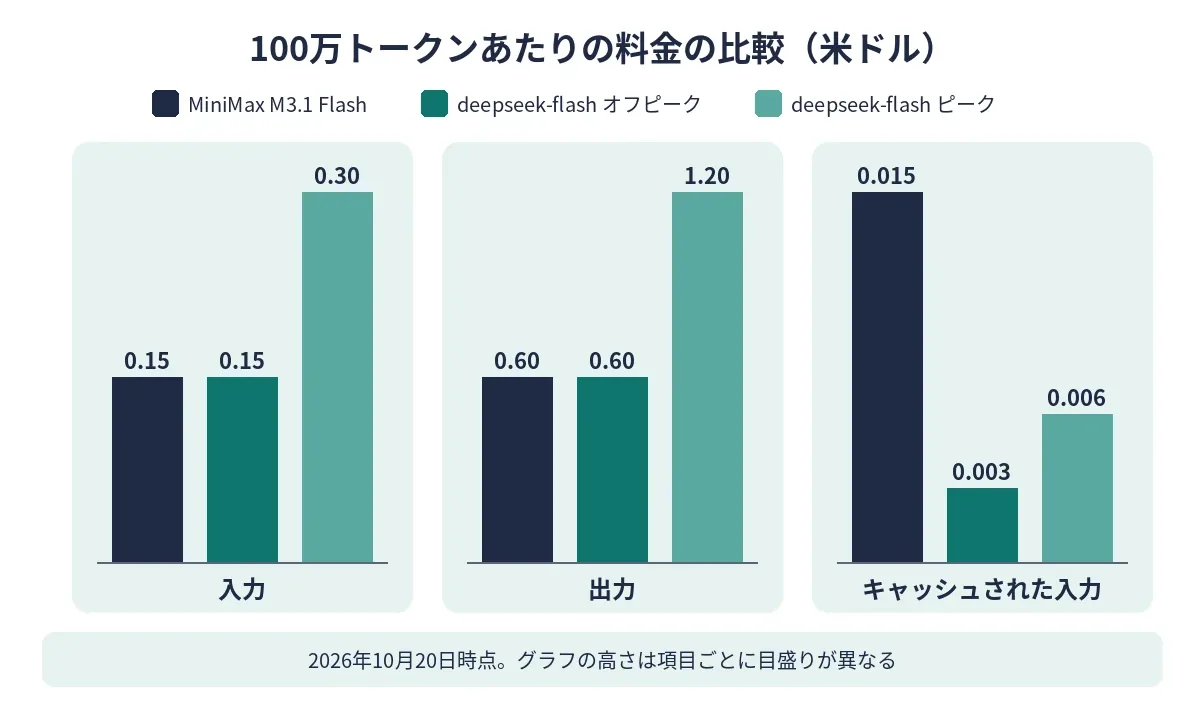
同じように安さを売りにしているDeepSeekのdeepseek-flash(DeepSeek-V4.1-Flash-1017)と、100万トークンあたりの料金を並べます。DeepSeekは公式の料金ページ(2026年10月20日時点)の金額で、時間帯によって値段が変わります。
| 項目 | MiniMax M3.1 Flash | deepseek-flash(オフピーク) | deepseek-flash(ピーク) |
|---|---|---|---|
| 入力 | 0.15ドル | 0.15ドル | 0.30ドル |
| 出力 | 0.60ドル | 0.60ドル | 1.20ドル |
| キャッシュされた入力 | 0.015ドル | 0.003ドル | 0.006ドル |
DeepSeekのピークは、中国の祝日をのぞく平日のUTC 1:00〜4:00と6:00〜10:00(日本時間では10:00〜13:00と15:00〜19:00)です。日本の昼間に多く使うなら、MiniMaxの一律料金のほうが計算しやすい場面もあります。実際の費用は、出力の長さや思考(thinking)の量でも変わるので、自分の使い方で試して比べてください。DeepSeekの新しいモデルについてはDeepSeek-V4.1-Flash-1017とは?で説明しています。
どこで使える?
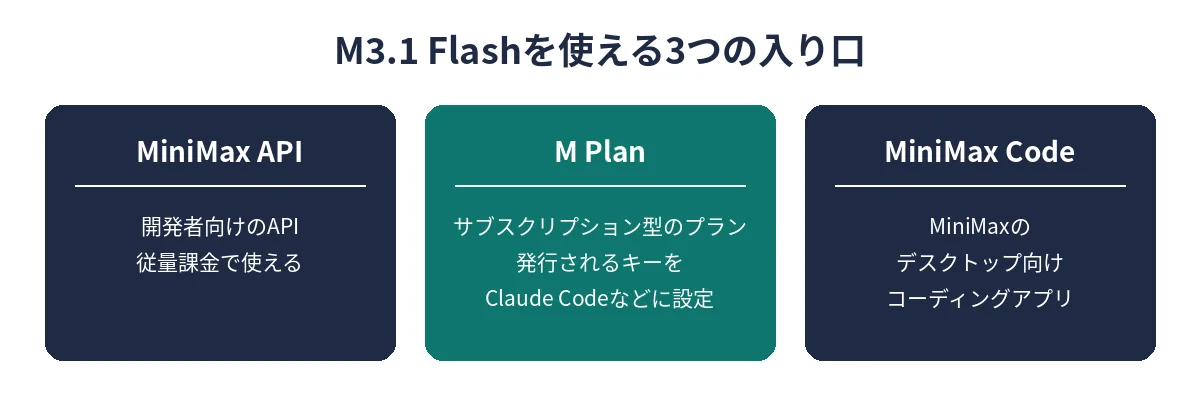
MiniMaxによると、M3.1 Flashを使える入り口は3つあります。
- MiniMax API:開発者向けのAPI。従量課金で使える
- M Plan:MiniMaxのサブスクリプション型のプラン。発行されるキーを、Claude CodeやCursorなどのコーディングツールに設定して使える
- MiniMax Code:MiniMaxのデスクトップ向けコーディングアプリ(ダウンロードページ)
モデルの重み(ウェイト)は「あとで公開する」とされていて、公開の時期は公式では未確認です。より性能を高めた「Pro」も、あとで出るとしています。
APIで呼び出す
MiniMaxのAPIは、OpenAI形式とAnthropic形式の両方に対応しています。モデル名は「MiniMax-M3.1-Flash」です。APIキーはMiniMaxの開発者向けサイトで作れます。
OpenAI形式で呼び出す例です。APIキーは環境変数に入れておきます。
export MINIMAX_API_KEY="ここに自分のAPIキー"

curl https://api.minimax.io/v1/chat/completions \
  -H "Authorization: Bearer $MINIMAX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMax-M3.1-Flash",
    "reasoning_effort": "low",
    "messages": [
      {"role": "user", "content": "こんにちは。自己紹介してください。"}
    ]
  }'
OpenAIのPython SDKを使っているなら、base_urlとモデル名を変えるだけで呼び出せます。
pip install openaiimport os
from openai import OpenAI
client = OpenAI(
base_url="https://api.minimax.io/v1",
api_key=os.environ["MINIMAX_API_KEY"],
)
response = client.chat.completions.create(
model="MiniMax-M3.1-Flash",
reasoning_effort="low",
messages=[{"role": "user", "content": "こんにちは。自己紹介してください。"}],
)
print(response.choices[0].message.content)思考の深さ(effort)に注意
M3.1 Flashは、答える前に必ず考える(thinking)モデルで、思考をオフにはできません。思考を止める指定を送ると、エラー(400)になります。
そのかわり、思考の深さを low・medium・high・xhigh・max の5段階で選べます。何も指定しないと、いちばん深い max になります。深くするほど出力トークンが増え、返事も遅くなるので、料金を抑えたいときや速さを優先したいときは、上の例のように low や medium を指定してください。
まとめ
- MiniMax M3.1 Flashは、2026年10月19日に出たエージェント・コーディング向けのモデル。コンテキストは100万トークン
- API料金は100万トークンあたり入力0.15ドル・出力0.60ドル・キャッシュ入力0.015ドルの一律
- 「70%安い」はエージェント用途での全体のコストの話。ベンチマークの数字もMiniMaxの発表
- MiniMax API・M Plan・MiniMax Codeで使える。重みの公開とProはこれから
- 思考はオフにできず、指定しないと max。費用と速さは effort で調整する
まずは effort を low にして、いま使っているモデルと同じ作業をさせ、かかったトークン数と答えの質を比べてみてください。

コメント