AIエージェントやアプリに、安い小型モデルを載せたい開発者は、まず次を確かめてください。
- モデルIDは
muse-ember-1.0。Meta Model APIとMuse Codeで使える(公式) - 料金の目安は、入力100万トークンあたり0.10ドル、キャッシュ入力0.004ドル、出力0.50ドル(入力20万トークンまでの標準)。それより長い入力は別レート
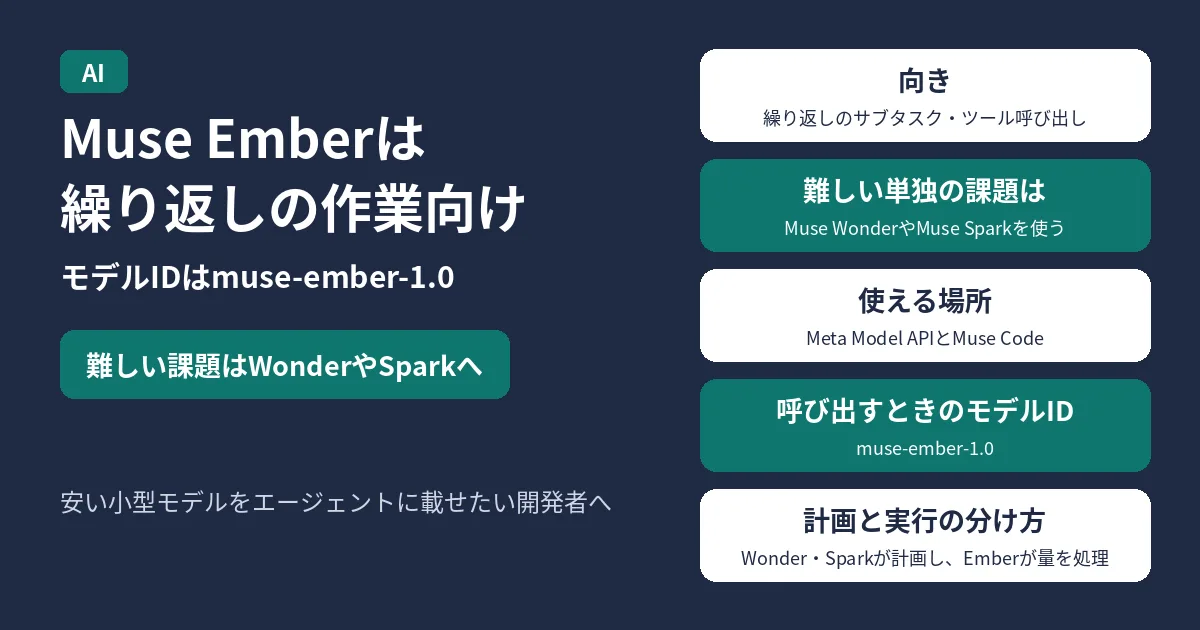
- 難しい単独のコーディングや知識寄りの質問には、公式がMuse SparkやMuse Wonderをすすめる。Emberは繰り返しのサブタスク向け
Metaは2026年11月9日、Museシリーズのなかでいちばん小さく効率的なモデルとしてMuse Emberを発表しました。エージェントが一日じゅう繰り返すツール呼び出し、コーディングのサブタスク、振り分け、長い文書の読み取り向け、と位置づけています。成績の数字は、Metaの発表どおりに書きます。
11月10日8時29分(日本時間)時点の、Metaの研究ブログとMeta Model APIのドキュメントにもとづく内容です。
結論:安い実行役。成績はMeta発表
| 項目 | 内容(公式) |
|---|---|
| モデルID | muse-ember-1.0 |
| 使える場所 | Meta Model API、Muse Code |
| 入力 | テキスト・画像・動画・音声・PDF |
| 出力 | テキスト |
| コンテキスト/最大出力 | 1,048,576トークン/524,288トークン(ブログでは100万/最大51万2千とも表記) |
| 料金(入力20万トークンまで・100万トークンあたり) | 入力0.10ドル/キャッシュ入力0.004ドル/出力0.50ドル |
| 料金(入力20万トークン超・同) | 入力0.30ドル/キャッシュ入力0.012ドル/出力1.50ドル(長い入力のレートが請求全体に適用) |
| 向き | 高頻度の繰り返し作業(サブエージェント、ツール呼び出し、振り分け、大量の画像・ファイル処理) |
公式のモデル比較では、難しい問題の計画はMuse WonderやMuse Sparkに任せ、量の多い実行はEmber、という組み合わせをすすめています。既存のMuse記事(Wonder、Spark Open、Glimmer 30B)もあわせて読めます。
料金
研究ブログでは、Meta Model APIの料金として入力100万トークンあたり0.10ドル・出力0.50ドル、キャッシュ入力0.004ドルと案内しています。ドキュメントの「Pricing and rate limits」では、入力トークン数(キャッシュ含む)で料金の段が分かれます。
- 入力20万トークンまで:入力0.10/キャッシュ0.004/出力0.50(100万トークンあたり・ドル)
- 入力20万トークン超:入力0.30/キャッシュ0.012/出力1.50。超えた分だけでなく、そのリクエスト全体が長い入力のレートになる
Emberは標準モード(Standard mode)のみ、とも書かれています(協力者向け割引のContributor modeの対象外)。レート制限の例として、ドキュメントには muse-ember-1.0 が毎分3,000リクエスト・毎分400万トークンとあります(ほかのモデルと同じ表)。
できること・向いている使い方
ドキュメントによると、EmberはMuseファミリーのなかの効率的な実行モデルです。大きなエージェントの内側で、サブエージェントの作業、ツール呼び出し、リクエストの振り分けを担い、大量の画像・ファイル・レコードに同じ処理を回す用途向けです。コンピュータ利用、画像の理解、ツール呼び出し、構造化出力、検索結果を答えの根拠にする機能(グラウンディング)に対応する、とあります。
研究ブログでは、テキスト・画像・音声・動画を追加の変換なしでそのまま理解する、と説明しています。ドキュメントの一覧では入力にPDFも含まれます。出力はテキストです。推論の強さ(Reasoning effort)は minimal から max で、既定は max です。
難しい単独のコーディング、知識寄りの質問、ビジュアル寄りのコーディングには、公式がMuse SparkまたはMuse Wonderをすすめています。エージェントでは、WonderやSparkが計画し、Emberが量を処理する形が想定されています。
Claude Haiku 5.5との違い(Meta発表の成績)
研究ブログは、どのreasoning設定でもClaude Haiku 5.5やGPT-6 Lunaより「1ドルあたりの知能」が高い、Haikuの最良スコアに約3分の1のコストで並ぶ、とMetaが述べています。表のArtificial Analysis Indexでは、Muse Ember(max)とClaude Haiku 5.5(max)がともに最良36、GPT-6 Luna(max)が28、とMeta発表の数字が載っています。
コストあたりの図表は、Artificial Analysisの結果を元にMetaが示したもので、Ember側のコストは提案価格/リスト価格での見積もり、との注記があります。第三者の独立評価そのものとして書かれているわけではない点に注意してください。詳細はMetaの評価レポートへのリンクを見てください。
ほかにMetaが載せている例(いずれもMeta発表・max設定の比較)では、AutomationBench-AAでEmber 37.8、Haiku 13.9、Luna 20.2などがあります。用途や設定で数字は変わります。
シリーズのなかでの位置
ブログによると、Muse EmberはMuse Wonder Fullを使って学習した最初のモデルです。シリーズの位置づけとしては、いちばん難しい問題向けがWonder、コーディングとエージェント向けがSpark、繰り返しのコーディング/エージェント作業を安く回すのがEmber、と整理されています。オープンウェイトのSpark OpenやGlimmerとは提供の形が違うので、自前ホストが必要かは各記事と公式の案内を見てください。
APIで呼び出すとき
ドキュメントでは、リクエストの形はMuse Sparkと同じで、多くの例はモデルIDを変えるだけで切り替わる、とあります。エンドポイントはResponses、Chat Completions、Messagesです。例:
model: "muse-ember-1.0"認証やSDKの手順は、Muse EmberのドキュメントとQuickstartを見てください。
よくある質問
Haiku 5.5より必ず安いですか?
トークン単価の表では、Emberの標準は入力0.10ドル・出力0.50ドル(100万トークンあたり)です。Haiku側の最新単価はAnthropicの料金ページで確かめてください。Metaは「Haikuの最良スコアに約3分の1のコストで並ぶ」と述べていますが、実際の請求はトークン数・reasoning・長い入力のレートで変わります。
ローカルで動かせますか?
取得したEmberの案内は、Meta Model APIとMuse Codeでの提供が中心です。オープンウェイトとしての配布は、このページ群ではSpark Open/Glimmer側の話です。Emberをローカル実行できる、という記載は、今回取った公式ページにはありませんでした。
成績はどこまで信頼できますか?
ここでのベンチマーク数字はMeta発表です。Artificial Analysis Indexの36同士の並びも、Metaの表からの引用です。自分のワークロードで試すのが確実です。

コメント