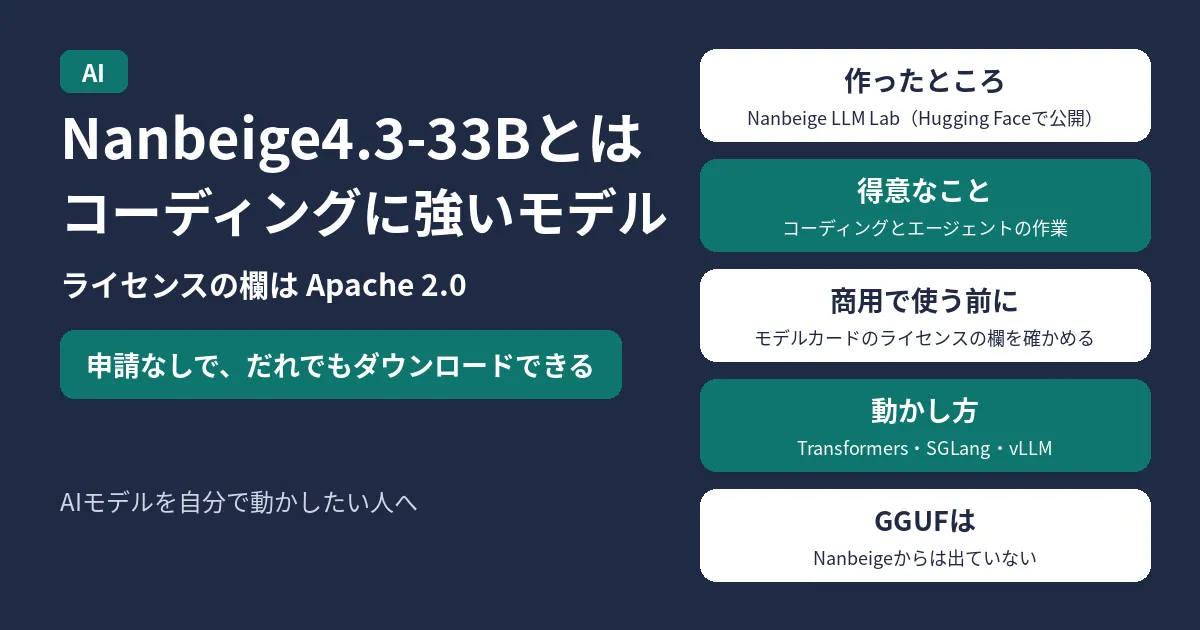
Nanbeige4.3-33Bは、
開発元の
- 2026年10月27日7時53分
(日本時間) 時点の、 Hugging Faceの モデルカードと ライセンスの 原文の 内容です。 - 公式の
動かし方は、 Transformers・ SGLang・ vLLMの 3つです。 SGLangと vLLMの 例は GPU4枚で 動かす 設定です。 - GGUFは
Nanbeigeからは 出ていません。 Hugging Faceに ある GGUFは、 ほかの 人が 作った ものです。
結論:だれでもダウンロードでき、ライセンスの欄はApache 2.0
| 知りたいこと | 答え |
|---|---|
| だれが |
だれでも。 |
| 商用で |
モデルカードの |
| 性能 | 開発元が |
| 動かし方 | Transformers・ |
Nanbeige4.3-33Bの早見表
| 項目 | 内容 |
|---|---|
| 作った |
Nanbeige LLM Lab |
| 公開 | Hugging Faceの |
| パラメーター数 | 33,118,977,024(BF16) |
| 入力と出力 | 文章を |
| 扱える長さ | 524,288トークン(512K) |
| 言語のタグ | 英語・中国語 |
| ファイル | 27個、 |
| ライセンス | Apache 2.0 |
モデルカードでは、
だれがダウンロードでき、商用で使えるか
ダウンロード:申請もログインも要らない
Hugging Faceの
hf download Nanbeige/Nanbeige4.3-33B --dry-run--dry-run を
hf download Nanbeige/Nanbeige4.3-33B --local-dir Nanbeige4.3-33Bhf コマンドが
pip install -U "huggingface_hub"商用:Apache 2.0の条件
モデルカードの
| 条項 | 書かれていること |
|---|---|
| 2. 著作権 | 無料・期限なし・世界中で、 |
| 3. 特許 | 作る、 |
| 4. 再配布 | 配る |
| 6. 商標 | 作った |
| 7. 保証なし | 「現状の |
Apache 2.0には、
性能:コーディングの8項目
表のpreserve_thinking を
| 項目 | この |
Qwen3.8-27B |
|---|---|---|
| Terminal-Bench 2.1 | 80.9 | 73.0 |
| Terminal-Bench 4.0 | 23.8 | 6.3 |
| DeepSWE | 65.5 | 42.5 |
| SWE-Bench Pro | 60.3 | 61.7 |
| SWE-Atlas-QnA | 50.8 | 41.9 |
| NL2Repo | 53.0 | 48.3 |
| Scicode | 52.6 | 46.7 |
| SkillsBench | 61.1 | 56.4 |
Nanbeige4.3-33Bは、
負けている項目
| 項目 | この |
|---|---|
| SWE-Bench Pro | 60.3。 |
| GDPval | 84.8。 |
| GPQA Diamond | 89.5。 |
コーディングの
動かし方:公式の3つの例
モデルカードには、
Transformers
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = 'Nanbeige/Nanbeige4.3-33B'
tokenizer = AutoTokenizer.from_pretrained(
  model_id,
  use_fast=False,
  trust_remote_code=True
)
model = AutoModelForCausalLM.from_pretrained(
  model_id,
  torch_dtype='auto',
  device_map='auto',
  trust_remote_code=True
)

messages = [{'role': 'user', 'content': 'Which number is bigger, 9.11 or 9.8?'}]
inputs = tokenizer.apply_chat_template(
  messages,
  add_generation_prompt=True,
  return_tensors='pt'
).to(model.device)
output_ids = model.generate(inputs, max_new_tokens=1024)
response = tokenizer.decode(output_ids[0][inputs.shape[-1]:], skip_special_tokens=True)
print(response)
SGLang
MODEL_PATH=/path/to/your/Nanbeige4.3-33B
python -m sglang.launch_server \
  --model-path ${MODEL_PATH} \
  --host 0.0.0.0 \
  --port 8000 \
  --tp-size 4 \
  --mem-fraction-static 0.8 \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder
vLLM
MODEL_PATH=/path/to/your/Nanbeige4.3-33B
vllm serve ${MODEL_PATH} \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.8 \
  --enable-auto-tool-choice \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder
MODEL_PATH には、hf download で--tp-size 4 と --tensor-parallel-size 4 は、0.0.0.0 は127.0.0.1 に
おすすめの設定
| 使い方 | 設定 |
|---|---|
| ツールを |
Temperature 1.0、 |
| 考える |
Temperature 0.6、 |
enable_thinking:考えてから答えるかどうか。 初期設定では オンで、 Falseにすると オフに なります。 preserve_thinking:前の返事の 考えた 中身を、 次の やりとりに 残すか どうか。 会話や 質問には False、ツールを 使う 作業や コーディングの エージェントには Trueがすすめられています。 - ツールを
渡す ときは、 tool_call_format="xml"がすすめられています。 jsonも使えます。
GGUFは公式ではない
Hugging Faceで
GGUFと
これから出るもの
- 技術レポート:Nanbeige4.3-3Bと
一緒に 出すと、 Nanbeige LLM Labの メンバーが Hugging Faceの 話し合いで 答えています (日本時間10月26日0時25分)。 - Nanbeige4.3-3B:Nanbeige4.2-3Bと
同じしくみで、 Nanbeige4.3-33Bから 力を 移して 作ると 答えています。 - FP8:出してほしいと
いう 声には 「もうすぐ (coming soon)」との 返事です。

コメント