Carbon-Xは、
申請や
手元で
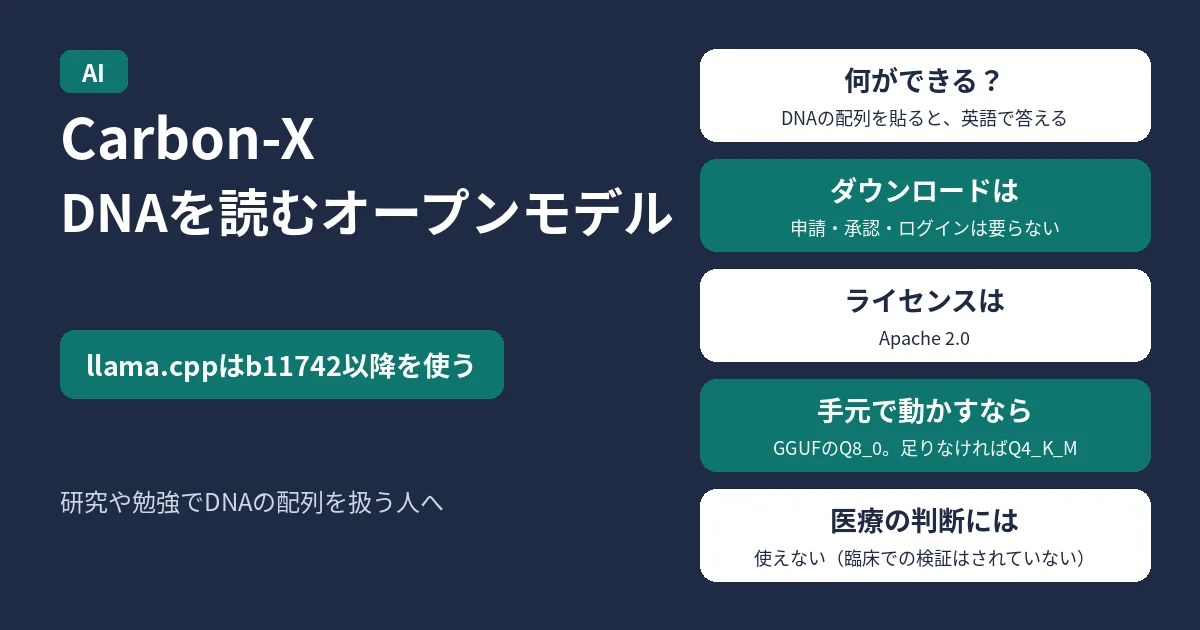
結論:だれでもダウンロードでき、Q8_0は約16GBのGPUメモリとKVキャッシュで動く
- Carbon-Xは、
Qwen3-14Bを もとに 作られた 14.8Bの モデルで、 DNAと 英語の 両方を 学習しています。 - 変異が
良性か 病原性か、 遺伝子の 働きを 調節する 領域、 どの 生物の グループの 配列か、 続く 塩基は 何かを 答え、 理由も 説明します。 - Hugging
Faceの リポジトリは 非公開でも gatedでもなく、 ログインしなくても ファイルを 取得できます。 - 手元で
動かすなら、 GGUFの Q8_0 (15.8GB)が おすすめです。 メモリが 足りない ときは Q4_K_M (9.6GB)を 使います。 - llama.cppで
動かす ときは、 b11742以降の バージョンが 要ります。 それより 前の バージョンでは、 DNAが 正しく 読み込まれません。
2026年10月26日8時32分
Carbon-Xの早見表
| 項目 | 内容 |
|---|---|
| 作った組織 | Hugging |
| もとの |
Qwen3-14B |
| パラメータ数 | 14.8B |
| 一度に |
40,960トークン |
| 答えの言語 | 英語 |
| ライセンス | Apache 2.0 |
| ダウンロード | 申請・ |
| リポジトリに |
2026年10月22日 |
| 手元で |
GGUFの |
| 医療の判断 | 使えない |
Carbon-Xが向いている人
研究や
一方で、
Carbon-Xでできること
モデルカードに
苦手な
Carbon-Xには、
A、
手元で動かすのに要るメモリとファイルの大きさ
手元でcarbon-x-q8_0.ggufのように、
| 種類 | 大きさ |
|---|---|
| BF16 | 29.7GB |
| Q8_0 |
15.8GB |
| Q6_K | 12.6GB |
| Q5_K_M | 11.1GB |
| Q4_K_M | 9.6GB |
Q8_0は、
メモリが
GGUFではなく、
動かし方:llama.cppのb11742以降で起動する
llama.cppは、
git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DGGML_CUDA=ON
cmake --build build -j --target llama-server llama-cliNVIDIAの-DGGML_CUDA=ONをllama-serverとllama-cliはbuild/binの
次の-hfで
llama-server -hf HuggingFaceBio/Carbon-X-GGUF:Q8_0 \
    -ngl 99 -c 40960 --jinja \
    --chat-template-kwargs '{"enable_thinking": false}' \
    --temp 0.6 --top-p 0.95 --top-k 20 --min-p 0 \
    --port 8080
-ngl 99は、すべての 層を GPUに 載せる 指定です。 - Carbon-Xは
考える 過程を 出さない 設定で 調整されているので、 enable_thinkingはfalseのままに します。 --temp 0.6、--top-p 0.95、--top-k 20、--min-p 0は、Carbon-Xの 標準の 設定です。 llama.cppのもともとの 設定とは 違うので、 そのまま 指定します。 -c 40960は、Carbon-Xが 一度に 読める 長さの すべてです。
先に-hf HuggingFaceBio/Carbon-X-GGUF:Q8_0を-m carbon-x-q8_0.ggufに
hf download HuggingFaceBio/Carbon-X-GGUF carbon-x-q8_0.gguf --local-dir .サーバーは
curl -s http://localhost:8080/v1/chat/completions -H "Content-Type: application/json" -d '{
  "messages": [{"role": "user", "content": "Is this sequence more likely coding or non-coding? ATGGCGCTGTGGATGCGCCTCCTGCCCCTGCTGGCGCTGCTGGCCCTCTGGGGACCTGACCCAGCCGCAGCC"}]
}' | jq -r '.choices[0].message.content'
遺伝子の
確かめ方:llama.cppのバージョンと、答えの中のDNA
まず、
llama-server --version表示されたbuildのversion:の
次に、<dna>と</dna>で
vLLMやTransformersで動かすとき
もとのtrust_remote_codeを
pip install -U vllm
vllm serve HuggingFaceBio/Carbon-X --trust-remote-code
初めて
気をつけること
- 臨床での
検証は されていないので、 医療の 判断には 使えません。 - 情報が
足りないと、 配列の 正体や 働きを 作り上げて 答える ことがあります。 答えの 生物学的な 内容は、 ほかの 方法でも 確かめてください。 - 長い
DNAの 配列を 作らせると、 質が 下がります。 Carbon-Xは、 今ある 配列を 読んで 説明する ための モデルで、 新しい 配列を 設計するようには 学習していません。 - 40,960トークンまで
入力できますが、 学習で 使った 長さ (約4万9千塩基まで)より 大幅に 長い 入力は 試されていません。
公式の情報
- Hugging
Face:HuggingFaceBio/Carbon-X (モデルカード) - Hugging
Face:HuggingFaceBio/Carbon-X-GGUF - Hugging
Face:Introducing Carbon-X (公式の ブログ) - GitHub:llama.cpp b11742

コメント