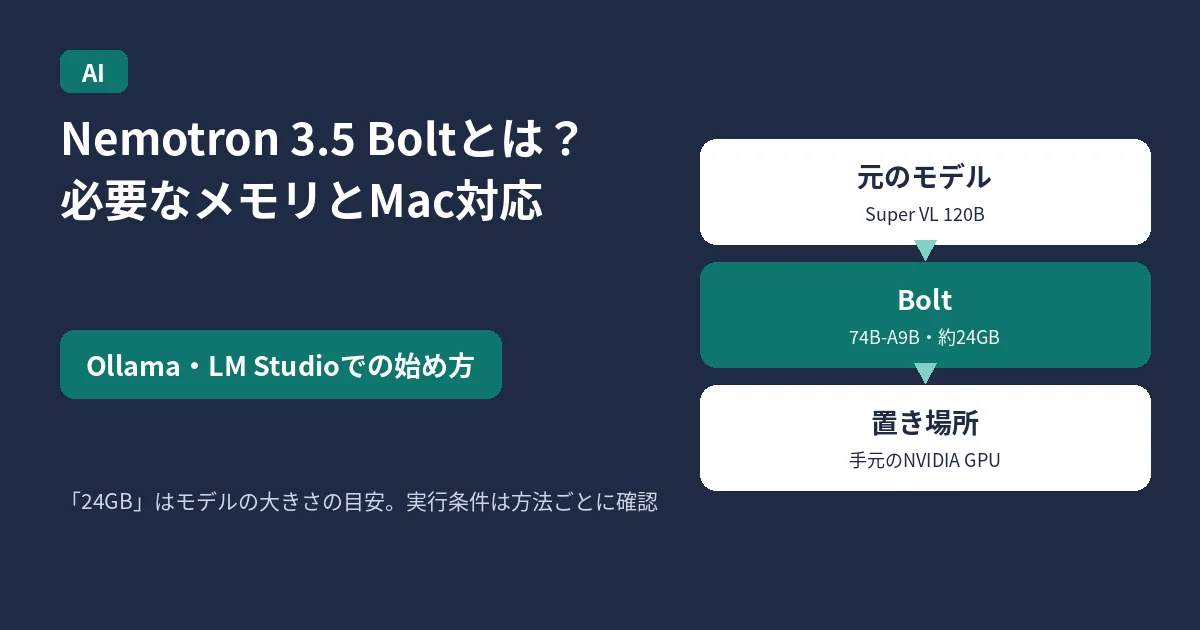
NVIDIAは2026年10月15日、自分のPCなど手元のNVIDIA製GPUで動かすことを狙ったオープンなAIモデル「Nemotron 3.5 Bolt 74B-A9B 24GB(ネモトロン 3.5 ボルト)」を公開しました。
結論から言うと、Boltは画像も読める74B(総パラメータ740億、同時に使うのは9B)のモデルを2ビット量子化し、約24GBのメモリに収まる形にしたローカル向けモデルです。ただし公式の実行レシピを見ると、「24GBのGPUがあれば必ず動く」とまでは言えません。また、Macについては、NVIDIA公式の対応OSにmacOSは含まれず、Ollama公式ページもApple Silicon(Metal)は現時点で非対応と明記しています。
この記事では、NVIDIA公式ブログ、Hugging FaceのNVIDIA公式モデルカード、OllamaとLM Studioの公式ページで確認できたことだけをもとに、「何ができるモデルか」「自分の環境で動くか」「始め方」を整理します。確認できなかったことは、そのように書きます。
Nemotron 3.5 Boltとは
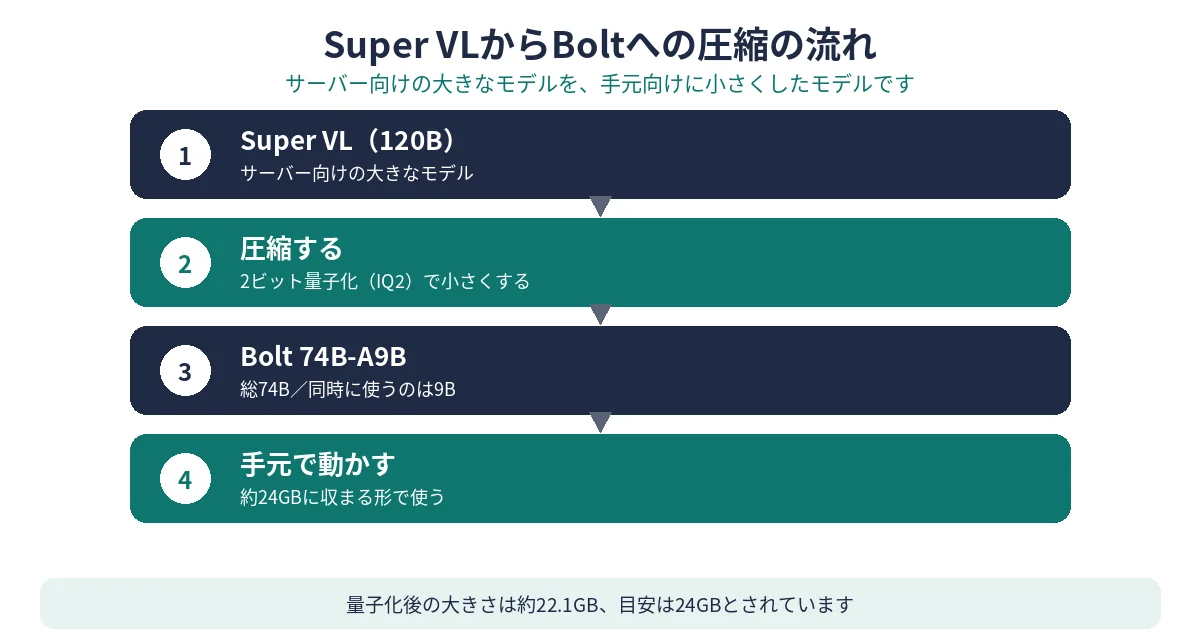
Boltは、NVIDIAのオープンモデル「Nemotron 3.5 Super VL(120B)」を圧縮して作られた、手元で動かすためのモデルです。Super VLが企業向けサーバーなどで使う大きなモデルなのに対し、BoltはNVIDIA RTXやDGX Sparkといった手元の環境で、日常のエージェント作業(調べもの、文章作成、コードのデバッグなど)をクラウドに送らずに進めることを狙っています。
| 項目 | 公式で確認した内容 |
|---|---|
| 公開日 | 2026年10月15日 |
| パラメータ数 | 総数74B(740億)、1トークンあたりに使うのは9B |
| しくみ | Mamba-2とTransformerを組み合わせたハイブリッド型のMixture-of-Experts(MoE)。画像用にC-RADIO v4-Hという視覚エンコーダーを使う |
| 量子化 | IQ2(2ビット量子化。量子化を前提に学習し直す方法で精度の低下を抑えている) |
| 入力/出力 | 入力はテキスト・画像・動画、出力はテキスト |
| コンテキスト長 | 最大256Kトークン(実際に使える長さはメモリなどに依存する) |
| 対応言語 | 主な言語は英語とプログラミング言語。日本語も対応言語に含まれるとモデルカードに記載 |
| ライセンス | OpenMDW-1.1(モデルカードでは商用・非商用で利用可能と記載) |
「74Bもあるのに24GBに収まる」のは、専門家の部分(エキスパート)を2ビットまで圧縮しているためです。モデルカードによると、量子化後のモデルの大きさは約22.1GB、パッケージとしての目安は24GBとされています。
何ができるモデルか
NVIDIA公式ブログとモデルカードでは、Boltの用途として次のようなことが挙げられています。
- 調べもの・文章作成・コードのデバッグ:公式ブログでは、Web調査、執筆、コードのデバッグといったプロジェクトを、人気のローカルエージェント基盤に任せる使い方が紹介されています
- ツール呼び出し:関数の呼び出しや、その結果を使った複数ターンの作業に対応します
- 画像の理解:スクリーンショット、グラフ、文書などの画像を読み取ることができます
- ターミナル操作やWebブラウジングに関わる作業:モデルカードでは、ローカルエージェントの基盤での利用や、ツール呼び出し・Web閲覧・ターミナル利用を含む一般的なエージェント作業に最適化されていると説明されています
- 推論のオン/オフ:答える前に考える「推論」を行うかどうかを切り替えることができます
なお、ベンチマークの順位や数値はNVIDIAが公開した測定結果です。この記事では順位の紹介にとどめ、実際に手元で使ったときの速度や賢さは、試していないため断定しません。
既存記事のSuper VL(1334)との違い
当サイトで紹介したNemotron 3.5 Super VLは、総120Bのモデルで、動かす構成の例としてH100を4枚などが挙げられている、サーバー向けのモデルでした。BoltはそのSuper VLを圧縮し、手元のNVIDIA GPUで動かせる大きさにしたモデルです。
| Super VL | Bolt 74B-A9B 24GB | |
|---|---|---|
| パラメータ数 | 総120B/アクティブ12B | 総74B/アクティブ9B |
| 主な置き場所 | 企業向けサーバーなど | 手元のNVIDIA RTX/DGX Sparkなど |
| 重みの形式 | BF16とNVFP4 | IQ2(2ビット)を中心とした量子化 |
| 位置づけ | 精度と処理量を狙う大きなモデル | 1GBあたりの賢さと速度のバランスを狙うローカル向けモデル |
Super VL自体の仕様は、こちらの記事でまとめています。
必要なメモリ:「24GBモデル」と公式レシピの違いに注意
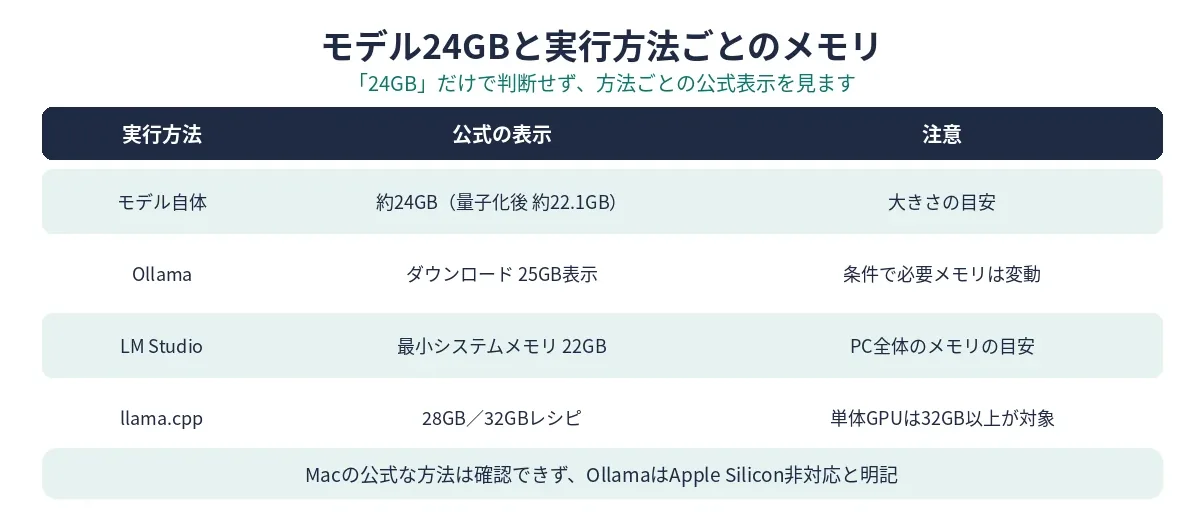
ここが一番間違えやすいところです。「24GB」はモデルの収まる大きさの目安であって、公式レシピが案内する実行環境のメモリは、使い方によってもう少し大きくなっています。
| 実行方法 | 公式で確認したメモリ・サイズ | 出典 |
|---|---|---|
| モデル自体(24GB版) | 24GBに収まる形でパッケージされている。量子化後の大きさは約22.1GB | Hugging Faceのモデルカード |
| Ollama | ダウンロードサイズは25GBと表示。必要なメモリはコンテキストの長さ、画像入力、推測デコーディングの有無で変わると明記 | Ollamaのモデルページ |
| LM Studio | 最小システムメモリは22GBと表示 | LM Studioのモデルページ |
| llama.cpp(GGUF版)28GBレシピ | RTXの単体GPUなら32GB以上、RTX Sparkなら64GBが対象。コンテキストは65,536トークン | Hugging FaceのGGUF版モデルカード |
| llama.cpp(GGUF版)32GBレシピ | RTXの単体GPUなら48GB以上、RTX Sparkなら128GBが対象。コンテキストは262,144トークン | Hugging FaceのGGUF版モデルカード |
とくに注意したいのは、LM Studioの「22GB」はシステムメモリ(PC全体のメモリ)の最小表示で、GPUのメモリ(VRAM)が22GBあれば動くという意味ではありません。また、llama.cppの公式レシピは28GBと32GBの2通りで、どちらもRTXの単体GPUでは32GB以上が対象になっています。
そのため、自分の環境で確かめるときは、次の順で見てください。
- GPUがNVIDIA製かどうか(後述のとおり公式対応はNVIDIA製GPUが前提)
- 使う実行方法(Ollama、LM Studio、llama.cppなど)ごとの公式表示。モデル名の「24GB」だけで判断しない
- 使いたいコンテキストの長さ。長くするほど必要なメモリは増える
「メモリ24GBのGPUでの具体的な手順」は、2026年10月19日時点でNVIDIA公式のレシピとしては確認できませんでした。24GBちょうどのGPUで動くかどうかは未確認です。
Macで動くか:公式対応は確認できず、Ollamaは非対応と明記
- 確認できたこと:Hugging FaceのGGUF版モデルカードでは、対応OSはWindowsとLinux、対応するGPUの世代はNVIDIA Ada LovelaceとBlackwellとされています。macOSは含まれていません。もう一方の(vLLMで使う)モデルカードでも対応OSはLinuxのみです
- 確認できたこと:Ollamaの公式モデルページには「Apple Silicon/Metalは現時点で対応していない」とはっきり書かれています。NVIDIAはCUDAでの導入手順を提供している、とも書かれています
- 確認できなかったこと:LM StudioのMac版でBoltが動くかどうかは、公式ページでは確認できませんでした。LM Studioのモデルページは「RTX GPUでのローカル利用」を前提とした説明で、最小システムメモリ22GBとだけ表示されています
つまり2026年10月19日時点では、Mac(Apple Silicon)でBoltを動かす公式な方法は確認できず、Ollamaについては非対応が明記されている、というのが正確なところです。今後対応が変わる可能性はありますが、この記事では「Macでは動かない」と言い切るのではなく、公式対応に含まれていないことと、Ollamaの非対応表示をもとに判断材料としてお伝えします。
Windowsについては、GGUF版の対応OSにWindowsが含まれていることを確認しました。Linuxも同様です。
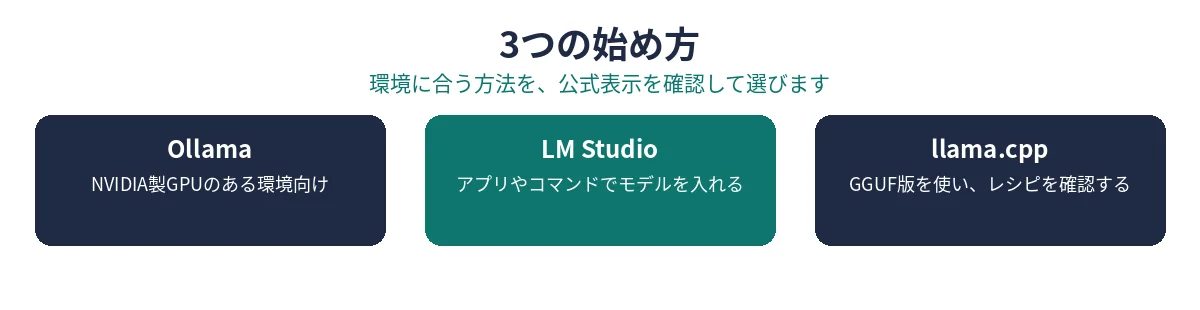
始め方1:Ollamaで動かす(NVIDIA製GPUのある環境向け)
ダウンロードサイズは25GBあるため、空き容量と通信量に注意してください。
ollama run nemotron-3.5-boltOllamaのページでは、Claude CodeやOpenCodeなどのエージェント基盤と組み合わせて起動する例も紹介されています。ただし前述のとおり、Apple Silicon/Metalは現時点で非対応です。また、必要なメモリはコンテキストの長さや画像入力などで変わります。
始め方2:LM Studioで動かす
lms get nvidia/nemotron-3.5-bolt-74b-a9bアプリの画面からモデルを検索して入れることもできます。LM Studioのページでは最小システムメモリが22GBと表示されていますが、これはPC全体のメモリの目安です。NVIDIA製GPUでの利用を前提とした説明になっているため、手元のGPUとメモリの両方を確認してください。Mac版での動作は公式では未確認です。
始め方3:llama.cppで動かす(上級者向け)
llama.cppで使うGGUF版は、Hugging Faceで公式に配布されています。
hf download nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF \
  NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  mmproj-NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB.gguf \
  --local-dir "$MODEL_DIR"
その後、llama.cppのサーバーとして起動します。公式モデルカードには、28GBレシピ(コンテキスト65,536)と32GBレシピ(コンテキスト262,144)の起動例が載っています。ビルド方法や細かいオプションは環境で変わるため、始める前にモデルカードの「Choose your deployment」の表で、自分のGPUとメモリに合うレシピを確認してください。
もう1つのBolt:E4B 4GBは10月23日公開予定
NVIDIA公式ブログでは、もう1つ小さい「Nemotron 3.5 Bolt E4B 4GB」が2026年10月23日に公開予定とされています。GeForce RTXやJetson、RTX/DGX Sparkで、速い会話型エージェントなどに使う想定です。2026年10月19日時点ではまだ公開されていないため、この記事の74B-A9Bとは分けて考えてください。公開後に、対応環境を公式で確認して追記する予定です。
使うときの注意
- モデルカードでは、AIシステムに組み込む前に、用途に合ったデータで追加のテストを行うことが重要だとされています。用意されている安全対策を、同等の対策なしに外さないよう呼びかけもあります
- 使えるコンテキストの長さは、メモリ、画像や動画の入力、会話履歴、ツールの結果などで変わります。「最大256K」をいつも使えるわけではありません
- この記事は公式資料をもとにまとめたもので、実際にBoltを動かして速度や回答の質を確かめたものではありません
まとめ
- Nemotron 3.5 Bolt 74B-A9B 24GBは、Super VLを圧縮した74B(アクティブ9B)の画像も読めるモデルを、2ビット量子化で約24GBに収めたローカル向けモデル
- できることは、調べもの・文章作成・コードのデバッグ、ツール呼び出し、画像の理解など。対応言語には日本語も含まれ、ライセンスはOpenMDW-1.1
- 「24GB」はモデルの大きさの目安。Ollamaは25GB表示、LM Studioは最小システムメモリ22GB、llama.cppの公式レシピは単体GPUで32GB以上が対象など、実行方法ごとに条件が違う
- MacはNVIDIA公式の対応OS(Windows/Linux)に含まれず、Ollama公式もApple Silicon/Metalは現時点で非対応と明記。LM StudioのMac版での動作は公式では未確認
- 始め方はOllama、LM Studio、llama.cppが公式に案内されている。小さいE4B 4GBは2026年10月23日公開予定
参考資料
- NVIDIA公式ブログ「Open From Data Center to Desktop: NVIDIA Expands Nemotron Family With Highest Efficiency Super VL and Bolt Models」(2026年10月15日)
- Hugging Face(NVIDIA公式)「nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB」モデルカード
- Hugging Face(NVIDIA公式)「nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB-GGUF」モデルカード(llama.cpp向けレシピ)
- NVIDIA Research「NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB」(技術解説)
- Ollama公式ライブラリ「nemotron-3.5-bolt」
- LM Studio公式モデルページ「nvidia/nemotron-3.5-bolt-74b-a9b」

コメント