「Kubernetes(クバネティス)って何?」「Dockerと何が違うの?」「Pod、Service、Deploymentの関係がよくわからない」。この記事は、そんな方向けのKubernetes入門です。仕組みと主要なリソースを図解でつかみ、最後にローカル環境で実際にアプリを動かすところまで進みます。
コンテナやDockerそのものの基本(イメージ、Dockerfile、Docker Compose)はDockerの基本と実践で解説しています。この記事では「たくさんのコンテナをどう管理するか」に絞って説明します。
Kubernetesとは?ひとことで言うと「コンテナの自動運用係」
Kubernetes(K8sとも書きます。最初の「K」と最後の「s」のあいだに8文字あることからの略称です)は、コンテナ化されたアプリケーションのデプロイ、スケーリング、管理を自動化するオープンソースのプラットフォームです。
Googleが社内で使っていたクラスター管理システム「Borg」とその後継「Omega」の経験をもとに開発され、2014年6月に最初のコードがGitHubに公開されました。2015年7月21日にバージョン1.0がリリースされ、同時にLinux Foundation傘下に新設されたCNCF(Cloud Native Computing Foundation)へ寄贈されています。2026年10月時点の最新の安定版はv1.37です。
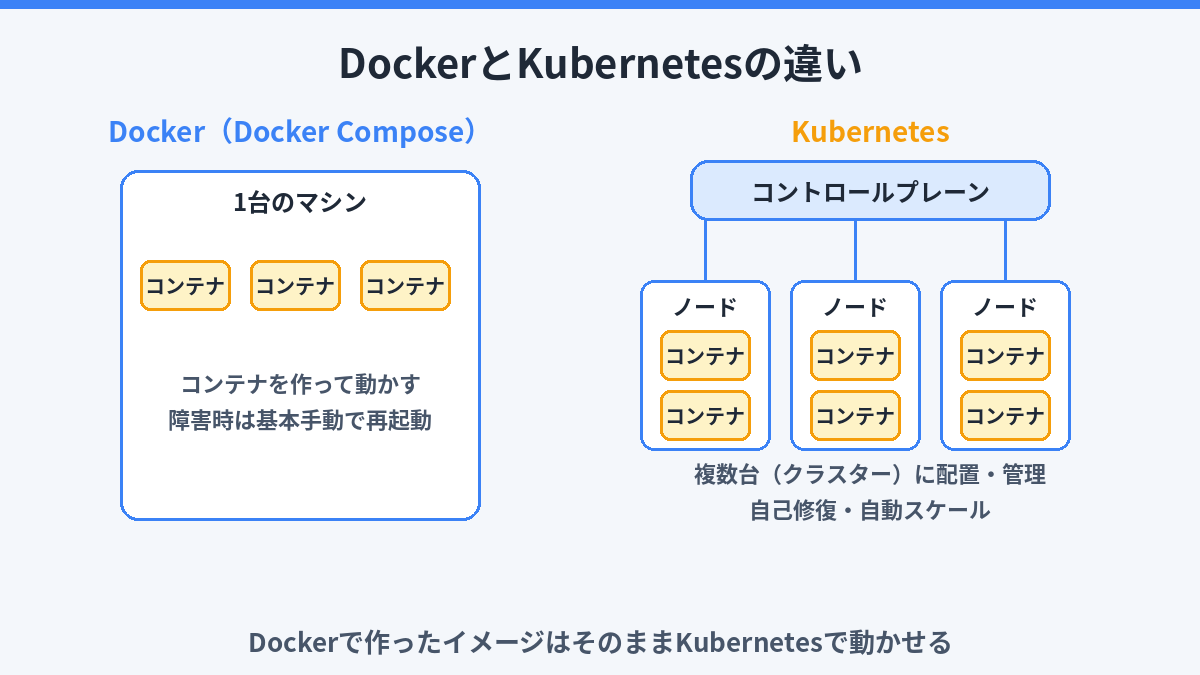
DockerとKubernetesの違い
| 項目 | Docker(Docker Compose) | Kubernetes |
|---|---|---|
| 主な役割 | コンテナを作って動かす | 多数のコンテナを複数台のサーバーで運用する |
| 規模 | 主に1台のマシン | 複数台のマシン(クラスター) |
| 障害時 | 基本は手動で再起動 | 自動で作り直す(自己修復) |
| 台数の増減 | 手動 | 設定に応じて自動でスケール |
なお、KubernetesはDocker専用ではありません。v1.24でDocker Engineとの橋渡し部品(dockershim)が削除され、現在はcontainerdやCRI-Oなど、CRIという標準インターフェースに対応したコンテナランタイムを使います。Dockerで作ったイメージはそのままKubernetesで動かせます。
Kubernetesが解決する3つの課題
- 自己修復:コンテナが落ちたら、自動で新しいものを起動して「あるべき状態」に戻す
- スケーリング:アクセスが増えたらコンテナの数を増やし、減ったら減らす
- ローリングアップデートとロールバック:新しいバージョンに少しずつ入れ替え、問題があれば元に戻す
ポイントは、「何台動かしたいか」というあるべき状態を宣言しておくと、Kubernetesがその状態を保ち続けてくれることです。これを宣言的な管理と呼びます。
Kubernetesの仕組み:クラスター・コントロールプレーン・ノード
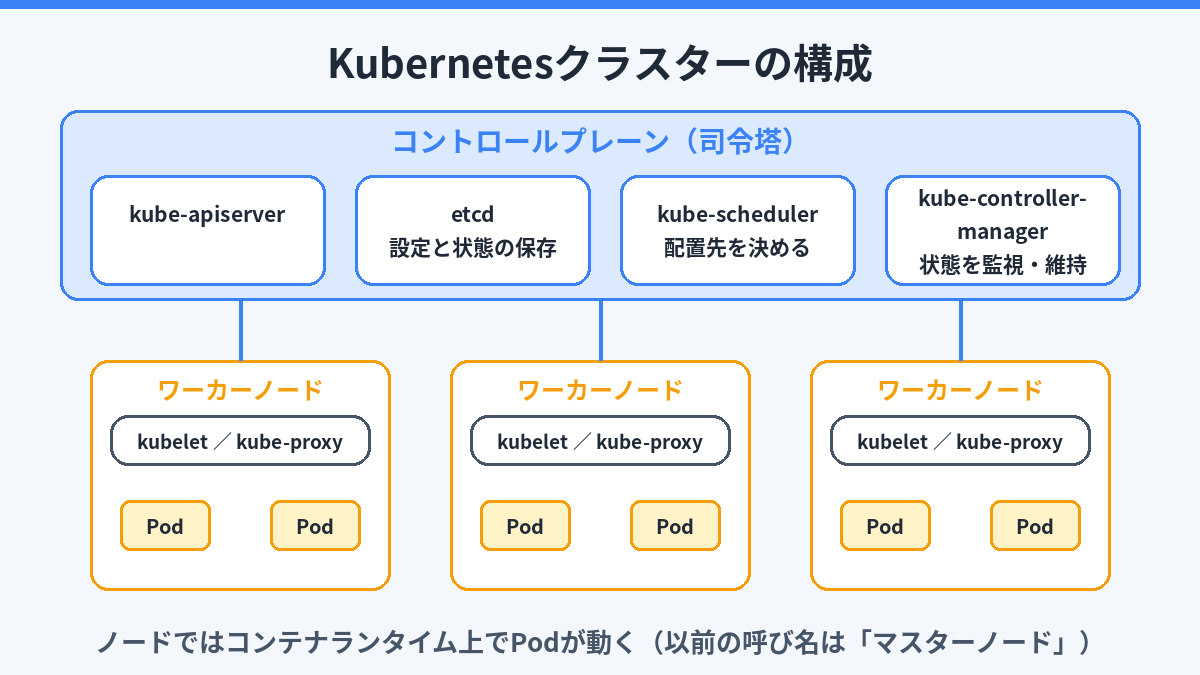
Kubernetesは、複数のマシンをまとめたクラスターとして動きます。クラスターは大きく2つの部分に分かれます。
| 部分 | 役割 | 主な構成要素 |
|---|---|---|
| コントロールプレーン | クラスター全体の司令塔。どこに何を動かすかを決め、状態を監視する | kube-apiserver、etcd(設定と状態の保存)、kube-scheduler、kube-controller-manager |
| ワーカーノード | 実際にコンテナ(Pod)が動くマシン | kubelet、kube-proxy、コンテナランタイム |
以前は「マスターノード」と呼ばれていましたが、現在の公式ドキュメントでは「コントロールプレーン」という呼び方が使われています。
まず覚えたい4つのリソース:Pod・Deployment・Service・Namespace
Pod:コンテナを動かす最小単位
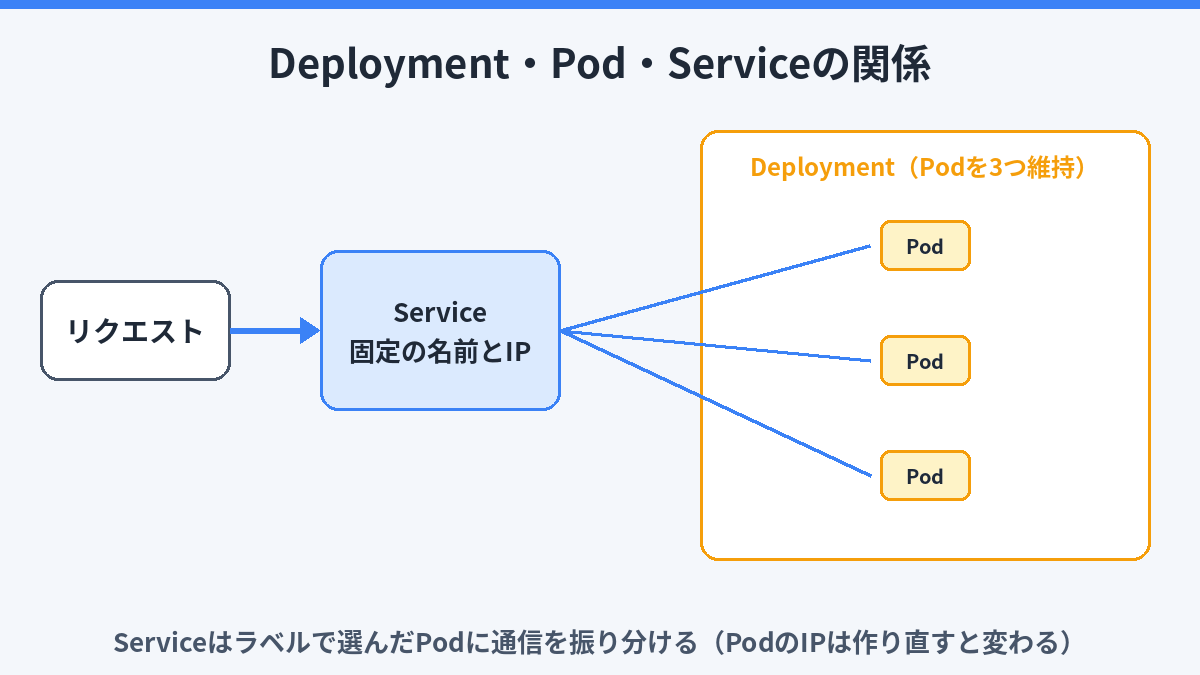
Podは、Kubernetesで動かせる最小の単位です。1つのPodには通常1つのコンテナが入り、密接に連携するコンテナを同じPodにまとめることもできます。Podは作り直されるたびにIPアドレスが変わる、使い捨ての存在です。
Deployment:Podの数とバージョンを管理する
Deploymentは「このイメージのPodを3つ動かす」といったあるべき状態を定義するリソースです。Podが落ちれば作り直し、イメージを更新すれば少しずつ新しいPodに入れ替えます。実際の運用では、Podを直接作るのではなくDeploymentを使うのが基本です。
Service:Podへの安定した入り口
PodはIPアドレスが変わるため、直接アクセスするのは不便です。Serviceは、ラベルで選んだ複数のPodに対して固定の名前とIPアドレスを提供し、通信を振り分ける入り口です。主な種類は次の3つです。
| Serviceの種類 | アクセスできる範囲 | 主な用途 |
|---|---|---|
| ClusterIP(初期値) | クラスターの内部だけ | アプリとデータベースなど、内部同士の通信 |
| NodePort | 各ノードのIPアドレスと特定のポート番号から | 検証用に外部から試す |
| LoadBalancer | クラウドのロードバランサー経由で外部から | EKS・GKE・AKSなどで本番公開する |
Namespace:クラスターを用途ごとに区切る
Namespaceは、1つのクラスターを「開発用」「検証用」のように論理的に分ける仕組みです。チームや環境ごとにリソースを整理できます。
外部公開の新しい標準:Gateway API
HTTPのルーティングで外部に公開する方法としては、これまでIngressが広く使われてきました。ただ、Ingress APIは機能追加が止まっており、代表的な実装だったIngress NGINXは2026年3月に開発・保守を終了しています。新しく学ぶなら、後継として位置づけられているGateway APIから触れるのがおすすめです。
ハンズオン:ローカルでKubernetesを動かしてみる
学習用には、PC上に小さなクラスターを作れるツールを使います。代表的なのはminikubeと、Dockerのコンテナをノード代わりにするkind(Kubernetes IN Docker)です。kindを使うにはDockerかPodmanが必要です。minikubeはDockerのほか、VirtualBoxなどの仮想マシンでも動きます(minikube公式ドキュメント)。操作にはkubectlというコマンドラインツールを使います。
1. クラスターを起動する(minikubeの例)
minikube start
kubectl get nodes
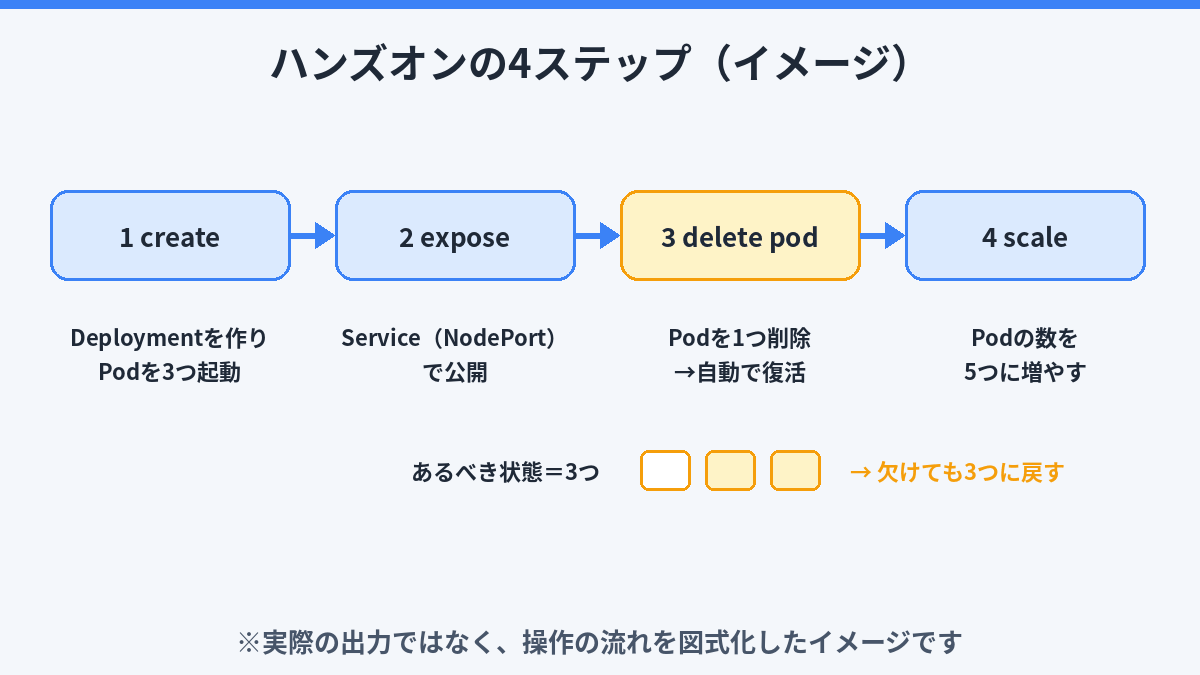
2. Deploymentを作ってPodを動かす
kubectl create deployment hello --image=nginx --replicas=3
kubectl get pods
3. Serviceで公開してアクセスする
kubectl expose deployment hello --type=NodePort --port=80
minikube service hello※MacやWindowsでDockerを使っている場合は、minikube serviceを実行したターミナルを閉じずに開いたままにしておいてください。閉じるとアクセスできなくなります。
同じDeploymentは、YAMLファイルに書いてkubectl apply -f hello.yamlで作ることもできます。最小限の例は次のとおりです。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: hello
spec:
  replicas: 3
  selector:
    matchLabels:
      app: hello
  template:
    metadata:
      labels:
        app: hello
    spec:
      containers:
      - name: nginx
        image: nginx
        ports:
        - containerPort: 80
4. 自己修復とスケールを試す
kubectl delete pod <Pod名のどれか1つ>
kubectl get pods
kubectl scale deployment hello --replicas=5
Podを1つ削除しても、Deploymentが「3つ」というあるべき状態に戻すために新しいPodを自動で作ります。これがKubernetesの自己修復です。
実際の運用では、こうした設定をYAMLファイル(マニフェスト)に書いてGitで管理し、kubectl apply -f で反映するのが一般的です。CI/CDとの組み合わせはCI/CDパイプラインの構築やGitHub Actions入門を参考にしてください。
次のステップ:本番に近い環境へ
- マネージドKubernetes:AWSのEKS、Google CloudのGKE、AzureのAKSを使うと、コントロールプレーンの運用をクラウド側に任せられます。クラウドの選び方はAWSとGCPの比較もどうぞ。
- インフラのコード化:クラスター自体の作成はTerraform入門で紹介しているIaCで管理できます。
- 設計の考え方:Kubernetesと相性のよい設計はマイクロサービスアーキテクチャで解説しています。
まとめ
- Kubernetesは、コンテナのデプロイ・スケーリング・自己修復を自動化するプラットフォーム
- クラスターは「コントロールプレーン(司令塔)」と「ワーカーノード(実行役)」でできている
- まずはPod・Deployment・Service・Namespaceの4つを覚え、minikubeやkindで手を動かすのが近道

コメント